工業互聯網小幀探第一季⑤ 工業互聯網數據服務——從數據到價值的最后一公里
工業互聯網小幀探第一季⑤:工業互聯網數據服務——從數據到價值的最后一公里
01 引言:數據泛濫,服務稀缺
在工業互聯網的世界里,數據被稱為“新時代的石油”。石油只有經過勘探、開采、提煉,才能變成汽油驅動汽車。工業數據同樣如此——每臺設備每分鐘產生的海量參數,如果不經過有效的處理、分析和應用,就只是沉睡在服務器中的數字垃圾。
工業互聯網小幀探第一季第五期,我們聚焦一個關鍵環節:工業互聯網數據服務。什么是數據服務?它如何將冰冷的數據轉化為實實在在的生產力?
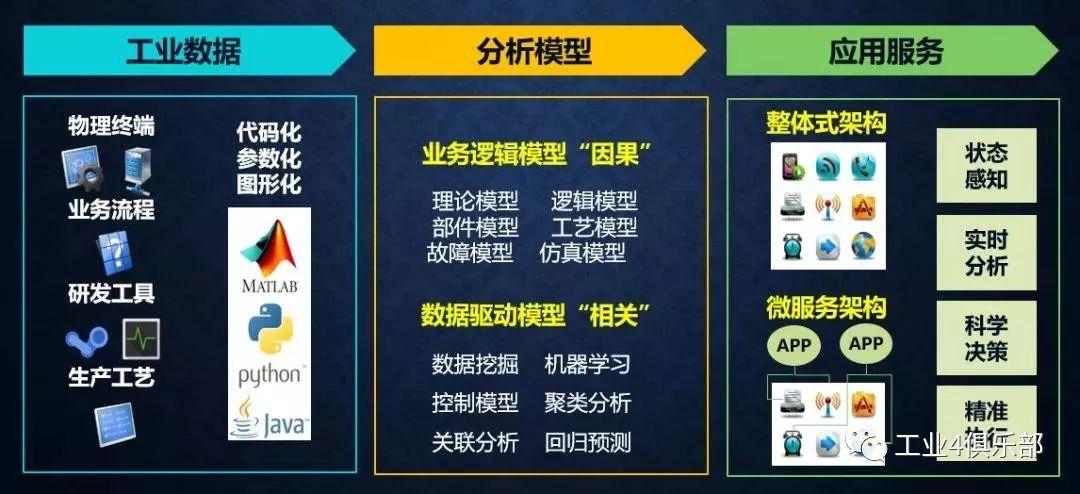
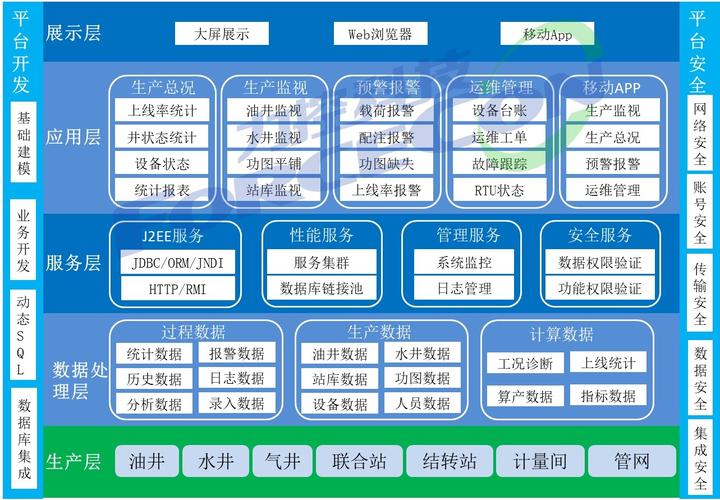
02 工業數據服務的三個層次
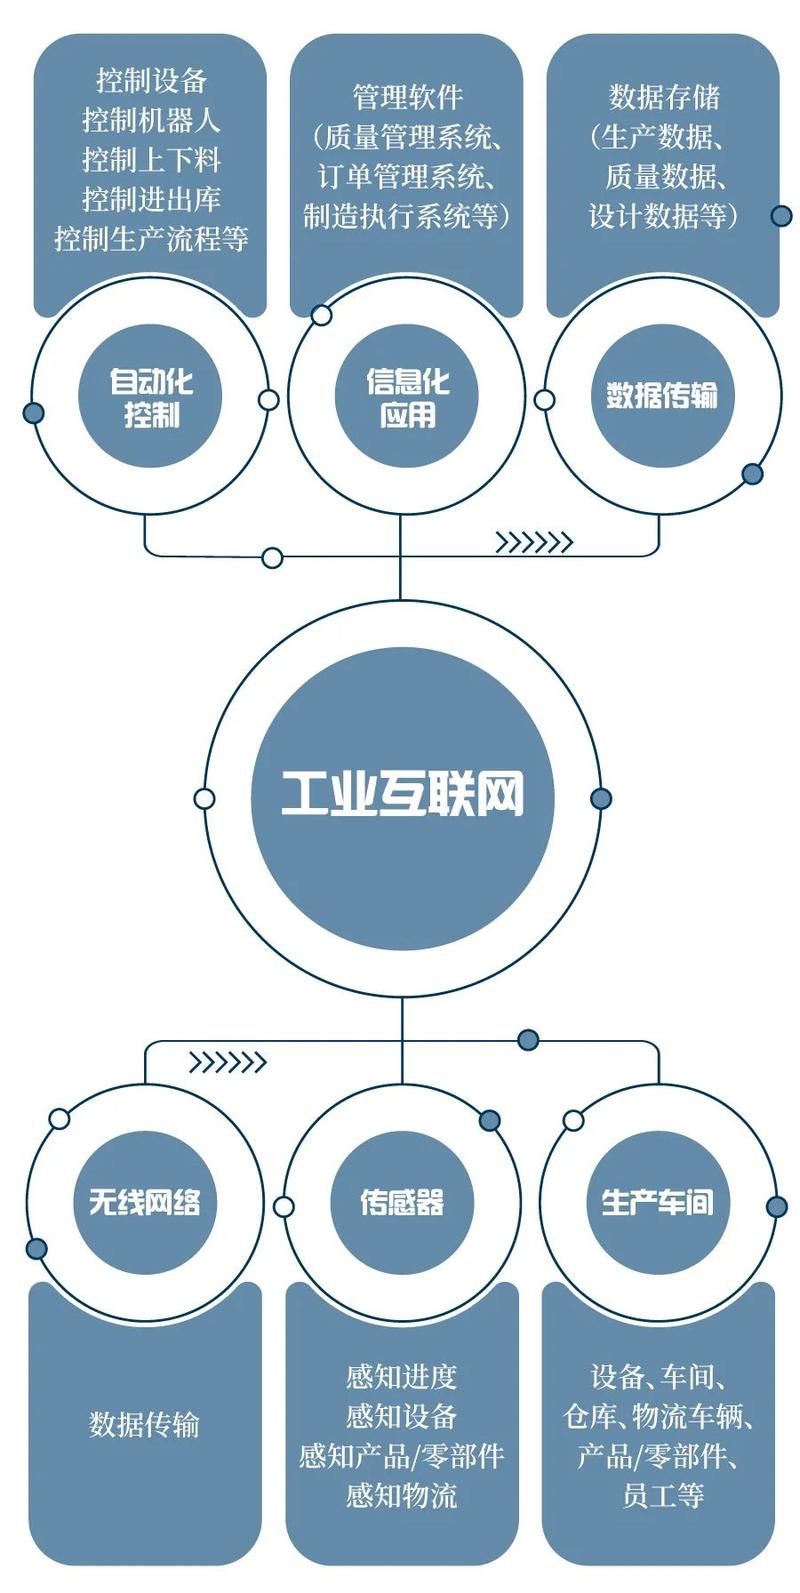
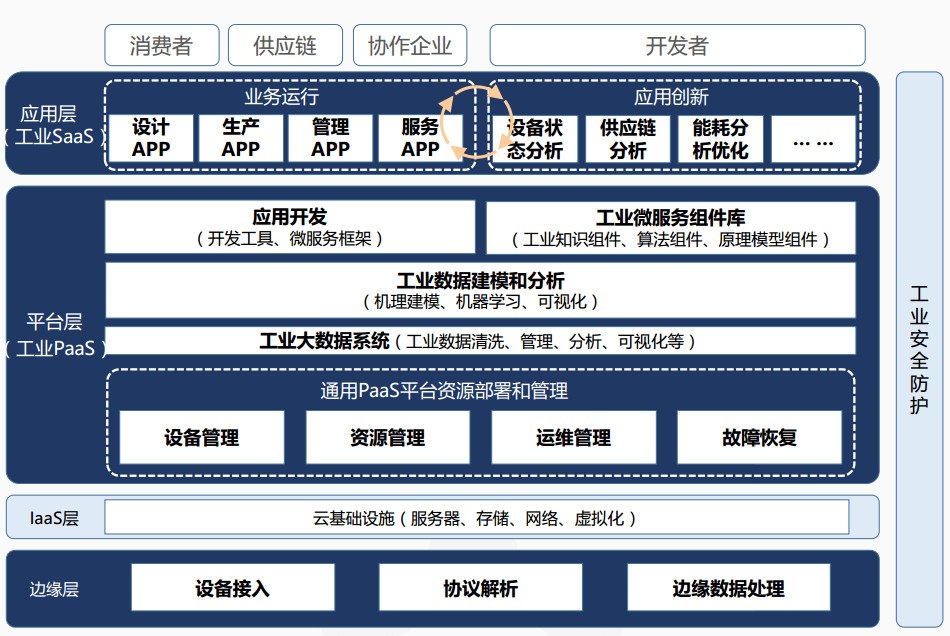
工業互聯網數據服務并非單一產品,而是一套層次分明的體系:
第一層:數據連接與采集服務
比如通過邊緣網關、工業協議解析(Modbus, OPC UA等),將不同品牌、不同年代的設備數據統一接入云平臺。這層解決“數據從哪里來”的問題。
第二層:數據存儲與治理服務
面對高頻、海量、時序化的工業數據,通用數據庫往往力不從心。工業時序數據庫(如InfluxDB、TDengine)以及數據湖方案,提供高效壓縮、快速查詢與數據質量管理。這層解決“數據怎么存、怎么管”的問題。
第三層:數據分析與智能服務
這才是價值核心——通過機器學習、機理模型、數字孿生等技術,實現設備預測性維護、工藝參數優化、能耗分析、質量溯源等應用。這層直接回答“數據有什么用”。
03 場景案例:數據服務如何落地
以一個典型的離散制造車間為例:
- 注塑機、CNC機床、機器人各自產生振動、溫度、電流波形數據。
- 數據采集服務將這些異構信號統一上傳。
- 數據治理服務篩除無效值,并對齊時間戳。
- 分析服務利用頻譜分析識別主軸軸承早期磨損,提前7天發出維護警報,避免非計劃停機。
另一例:流程行業中的水泥回轉窯,通過數據服務融合熱工參數與原料成分,建立燒成帶溫度軟測量模型,將煤耗降低3%~5%。
結果:數據服務讓工廠從“事后維修”轉向“預測性維護”,從“人工經驗”轉向“數據決策”。
04 關鍵挑戰與破局點
盡管前景廣闊,工業數據服務仍面臨三大挑戰:
其一,數據孤島依然頑固。 不同廠商設備數據格式封閉,接口不開放。破局需要推動OPC UA over TSN等統一標準,以及發展低代碼數據集成工具。
其二,數據質量參差不齊。 傳感器漂移、缺失值、噪聲嚴重影響模型準確率。需要內嵌數據清洗與數據增強服務模塊。
其三,數據分析落地門檻高。 懂工業的不懂AI,懂AI的不懂工藝。破局需要“工業機理+數據科學”的混合建模平臺,以及面向工藝工程師的低代碼分析工具。
05 未來趨勢:數據服務即運營
工業互聯網數據服務的終局,不是一次性交付項目,而是持續運營。
- 訂閱制:按月付費獲取設備健康評分模型。
- 數據交易市場:脫敏后的工藝參數可合規交易,用于行業對標。
- 聯邦學習:在不共享原始數據的前提下,跨工廠聯合訓練模型。
下一期,我們將深入“工業互聯網安全”,看數據服務在開放與保護之間如何走鋼絲。
06 小幀探筆記
- 數據服務 = 采集層 + 治理層 + 分析層,三層缺一不可。
- 核心價值:把工業現場的無序數據,變成可用于降本、增效、提質、減存的決策依據。
- 落地關鍵:以場景為錨,先從一條產線或一類設備切入,跑通閉環再復制。
- 記住一句口訣:接入是基礎,治是功夫,析是價值,用是終身。
下集預告——工業互聯網小幀探第一季⑥:工業互聯網安全,眼觀六路,耳聽八方,哨兵不掉線。
最新產品